NVIDIA нашла способ ускорить эмуляцию вычислений с плавающей точкой двойной точности на ИИ-ускорителях
В разнообразных вычислительных задачах науки — начиная с моделирования молекул и заканчивая разработкой новых материалов — основная часть процессорного времени тратится на операции умножения плотных матриц (GEMM) с высокой точностью: DGEMM (для вещественных чисел с плавающей запятой двойной точности, 64 бита) и ZGEMM (для комплексных чисел с плавающей запятой двойной точности, 64 бита). В сфере высокопроизводительных вычислений (HPC) и искусственного интеллекта для ускорения GEMM и прочих базовых операций линейной алгебры (BLAS) на ускорителях NVIDIA повсеместно применяется библиотека cuBLAS.
Стремительное совершенствование аппаратных решений, ориентированных на вычисления с пониженной точностью, подтолкнуло к созданию нового семейства алгоритмов. Эти алгоритмы дают возможность получать результаты с полноценной двойной точностью, задействуя при этом более производительные тензорные ядра (Tensor Cores), которые изначально разрабатывались для целочисленных операций.
Как подчеркнули в NVIDIA, начиная с версии CUDA Toolkit 13.4.2 при работе с cuBLAS больше не требуется делать выбор между точностью и быстродействием. Библиотека раскладывает каждое число двойной точности на целочисленные составляющие, перемножает их на тензорных ядрах, а после этого восстанавливает точный результат. Полученные значения обладают полной точностью (double precision), однако сами вычисления проходят без привлечения аппаратных FP64-блоков.
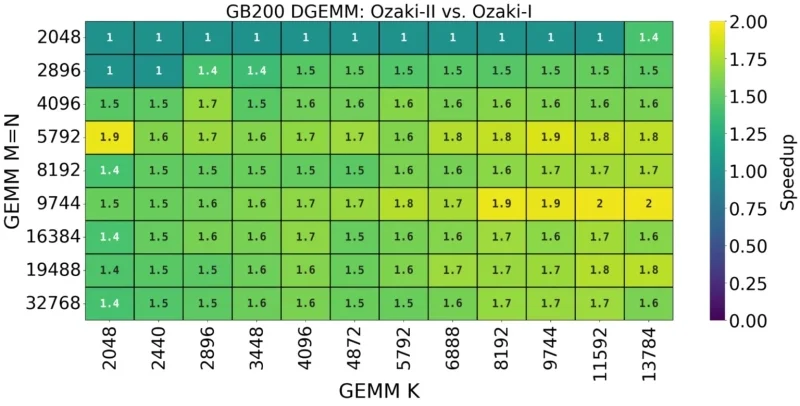
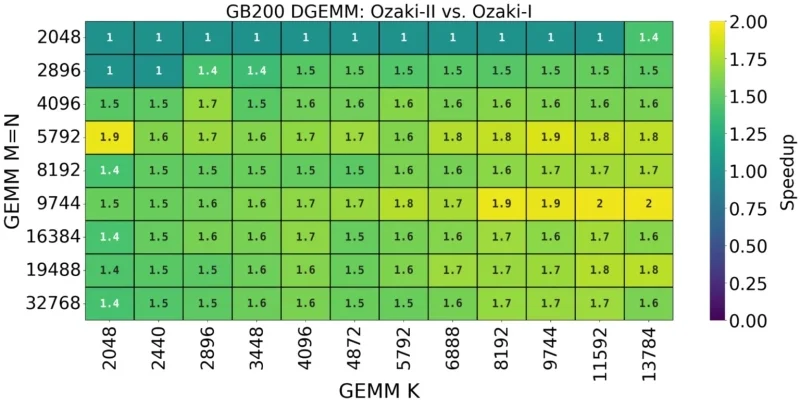
Повышению производительности процесса содействуют два новых алгоритма: схема Ozaki-II требует меньшего числа целочисленных умножений, чем предшествующая версия Ozaki-I, а алгоритм 2M для результативного перемножения комплексных матриц уменьшает количество операций в сравнении с традиционным подходом — с четырёх до двух. В основе решения лежит концепция автоматической динамической точности (Automatic Dynamic Precision, ADP). Схемы Озаки-I и Озаки-II обладают общим первым этапом, однако различаются методом выполнения умножения больших целых чисел. cuBLAS применяет эвристический подход для автоматического выбора между алгоритмами ради достижения максимальной производительности, хотя предусмотрен и ручной выбор типа расчётов.
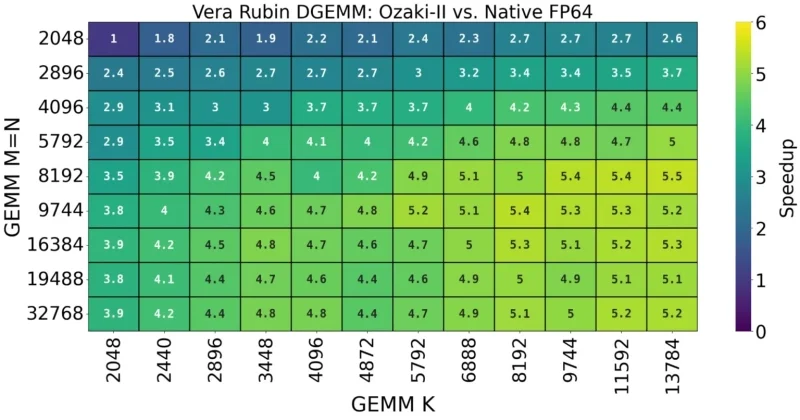
Архитектура Rubin предлагает новый числовой формат — TI16 (12-битное знаковое целое с диапазоном значений от -2047 до +2047), который прекрасно подходит для ускорения вычислений по схеме Озаки. В библиотеке cuBLAS 13.4 формат TI16 задействуется для ускорения Ozaki-I и Ozaki-II посредством инструкции `tcgen05.mma` на ускорителях Rubin. На приведённом ниже рисунке продемонстрирован прирост скорости операции DGEMM в cuBLAS при применении метода Ozaki-II в сравнении с нативным FP64 на системе VR200 NVL72.
Максимальный выигрыш в производительности определяется тем, как соотносится пропускная способность целочисленных тензорных ядер ускорителя с мощностью его аппаратных модулей, выполняющих расчёты в формате FP64. У разных моделей устройств это соотношение заметно отличается. Компания показала это на примере ускорителя RTX PRO 6000 Blackwell Server Edition. Ниже на схеме приведено ускорение DGEMM при применении подхода Ozaki-II в сравнении со штатным исполнением FP64 на этой модели.
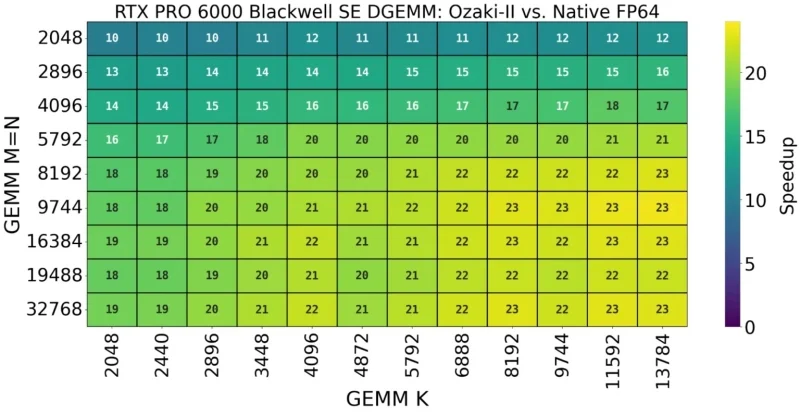
Использование Ozaki-II даёт выигрыш на всех протестированных размерах матриц: для самых компактных матриц быстродействие увеличивается в 10 раз, а для наиболее крупных — в 23 раза. NVIDIA сознательно делает ставку на эмуляцию для ускорения HPC-нагрузок на ИИ-чипах, вместо того чтобы разрабатывать отдельные блоки для аппаратных FP64-вычислений. В AMD, напротив, придерживаются мнения, что FP64 по-прежнему остаётся эталоном для научных расчётов, а подход NVIDIA оправдан далеко не во всех сценариях.
Специалисты AMD убеждены, что сегодня «сырую» производительность FP64 заменить нечем, и намерены поднять нативную FP64-производительность ускорителя Instinct MI430X. Ожидается, что в рамках «Миссии Генезис» (Genesis Mission) будут задействованы оба подхода, однако основной упор сделают на эмуляцию. Впрочем, NVIDIA Rubin HPC в любом случае обещает заметно ускорить обработку HPC-задач, но до релиза этого ускорителя ещё далеко.
Материалы по теме:
- AMD анонсировала ускорители Instinct MI450X с сокращённым объёмом памяти
- FP64 — не панацея: Мацуока выступил в поддержку Озаки
- AMD и NVIDIA пошли не тем путём: следующий большой американский суперкомпьютер может быть оснащён HPC-чипами NextSilicon
- Жить без CUDA невозможно? Конкурентное превосходство NVIDIA в области ПО для ИИ постепенно исчезает
- AMD анонсировала ускорители Instinct MI450X с сокращённым объёмом памяти
Источник:
- nvidia.com