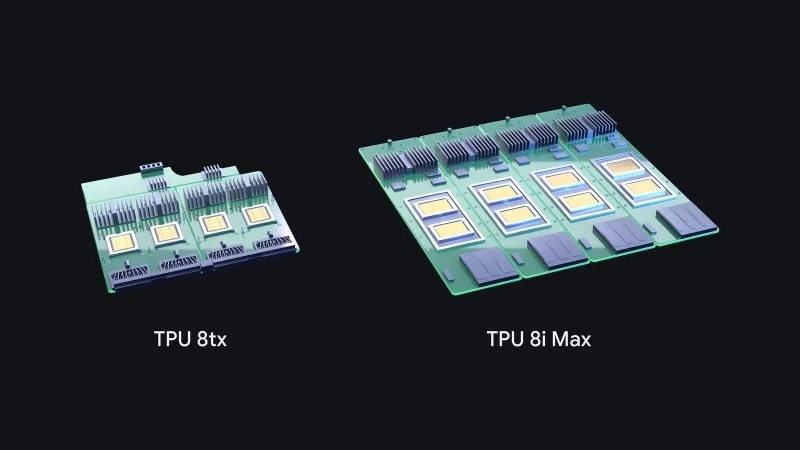
Компания Google анонсировала ИИ-ускорители TPU 8tx и TPU 8i Max. Вместе с представленными ранее в текущем году TPU 8t и TPU 8i линейка TPU восьмого поколения от Google теперь насчитывает четыре модели.
В своём блоге Амин Вахдат (Amin Vahdat), старший вице-президент и главный технолог Google по направлениям ИИ и инфраструктуры, подчеркнул, что ускорители TPU восьмого поколения созданы «для решения специализированных задач на различных стадиях жизненного цикла ИИ: TPU 8t — для крупномасштабного обучения моделей; TPU 8i — для низкозадержкового инференса; TPU 8tx — для конфиденциальных вычислений; а TPU 8i Max — для работы с гигантскими контекстными окнами и обеспечения предельной вычислительной плотности в серверной стойке».
Основой этого поколения выступили TPU 8t и TPU 8i: TPU 8t представляет собой инструмент для тренировки масштабных фундаментальных моделей, демонстрирующий наивысший показатель «полезной производительности» (goodput) — то есть объём результативных вычислений на каждый затраченный ватт энергии. В свою очередь TPU 8i — это вычислительный модуль для инференса и «рассуждений», спроектированный для преодоления «барьера памяти» (memory wall) и снижения задержек при обмене данными между чипами — вплоть до 50 %.
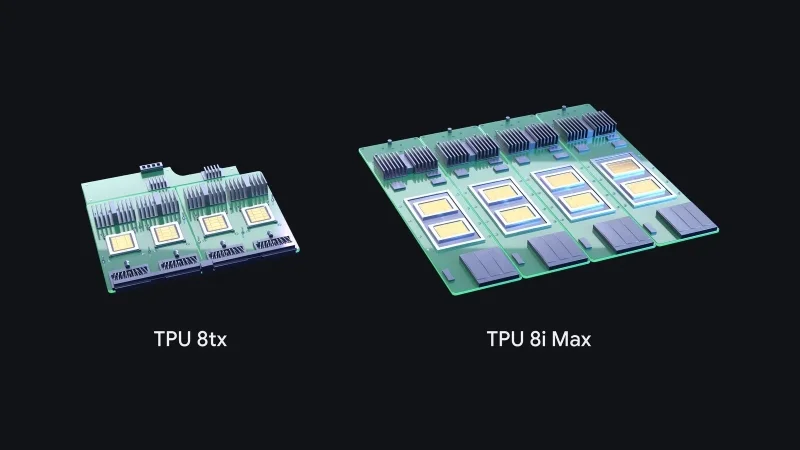
Изображения взяты из открытых источников: Google
Что касается TPU 8tx, то он ориентирован на конфиденциальный и безопасный инференс, а также на обучение моделей в ограниченных масштабах. Решение адресовано компаниям из регулируемых сфер и госучреждениям, которые применяют продвинутые или собственные модели и автономных агентов для обработки особо чувствительной информации.
TPU 8tx использует ту же аппаратную платформу, что и TPU 8t, и взаимодействует с процессорами AMD EPYC Turin. Аппаратный уровень защиты гарантирует, что конфиденциальные данные и веса моделей остаются изолированными и защищёнными даже в процессе использования. Благодаря низколатентной сетевой топологии Boardfly TPU 8tx ускоряет работу многоэтапных агентов: задержка сокращается вдвое по сравнению с TPU 8t при практически неизменной производительности.
Кроме того, TPU 8tx даёт возможность дообучать модели на собственных закрытых данных, выполнять дистилляцию крупных моделей и проводить обучение с подкреплением агентов, не перенося конфиденциальные данные между отдельными кластерами.
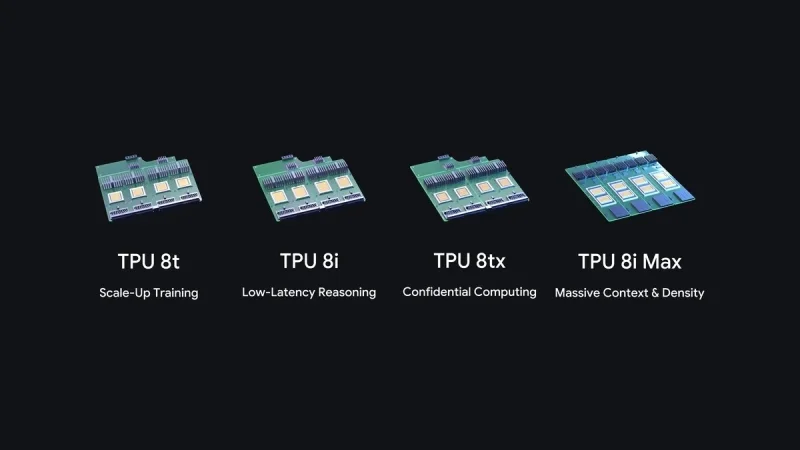
Модель TPU 8i Max, созданная путем объединения двух TPU 8i, появилась как ответ на вызов «барьера памяти» (memory wall) — несоответствия между вычислительной скоростью и пропускной способностью памяти. Двухчиповая конфигурация обеспечивает двукратный прирост вычислительных ресурсов, удвоенный объем SRAM и вдвое более высокую пропускную способность HBM в сравнении с TPU 8i. В данной системе вычислительная мощность и объем памяти увеличиваются пропорционально. Благодаря тому, что TPU 8i Max вмещает вдвое больше кремниевых компонентов в пределах той же серверной стойки, дата-центры получают возможность существенно нарастить вычислительную мощность на единицу площади и на ватт потребляемой энергии, сообщил Вахдат.
Вахдат также отметил, что компания представила набор инструментов TPU Agent (доступен в режиме превью) для упрощения оптимизации оборудования. Он встраивается в среды разработки — такие как Claude Code, Cursor и Google Antigravity — и позволяет за считанные минуты подготовить систему к работе с TPU, обнаружить «узкие места» и автоматически настроить ядра (kernels) с помощью простых текстовых команд. Для промышленного применения был создан открытый движок XLA Serving Engine, который дает возможность обучать модели на Python, а затем запускать их в высокопроизводительной среде на C++ с минимальной задержкой — на базе TPU, GPU или CPU.
Связанные публикации:
- Космический дата-центр Google Suncatcher установил связь и сочинил хайку
- Oracle первой среди гиперскейлеров начнёт предлагать Google TPU
- OpenAI решила закупать ИИ-процессоры Google, чтобы снизить зависимость от Nvidia
- Авиационная связь в США наконец перестанет опираться на дискеты
- Портфель заказов GE Vernova вырос до $197 млрд на фоне спроса на газовые турбины для ИИ-ЦОД
Источник: