M**a анонсировала Flattened Planar Fabric — сетевую архитектуру для ИИ с восемью узлами на один
Компания Meta✴ анонсировала ИИ-архитектуру под названием Flattened Planar Fabric (FPF), предназначенную для расширения крупномасштабной инфраструктуры искусственного интеллекта и обеспечения вычислительных задач следующего поколения. В рамках FPF каждый GPU соединяется через восемь отдельных каналов пропускной способностью 100 Гбит/с с восемью различными коммутаторами.
Изображения предоставлены: Meta✴
Данный метод заменяет классическую схему с отдельными восходящими линиями (uplink), предлагая четыре основных достоинства:
- Возможность формирования более масштабных неблокирующих кластеров GPU.
- Упрощённая топология: переход от трёхуровневой архитектуры Clos (применявшейся в сети NSF) к двухуровневой. Устранение одного яруса коммутаторов сокращает число сетевых переходов (hops), снижает задержки и уменьшает расходы на инфраструктуру.
- Аппаратная балансировка нагрузки на уровне сетевого адаптера (NIC), который распределяет трафик по восьми каналам вместо коммутатора.
- Централизованный контроль отказоустойчивости, охватывающий и коммутаторы, и хосты, что даёт хосту возможность перенаправлять трафик в обход неисправных маршрутов.
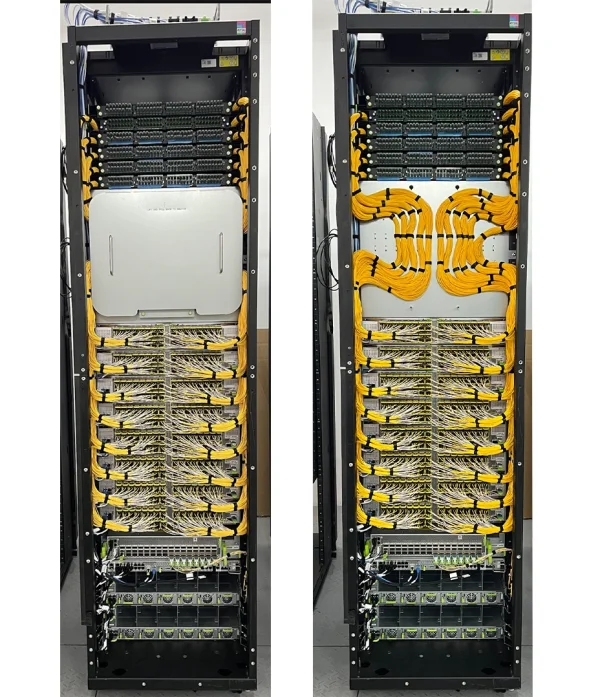
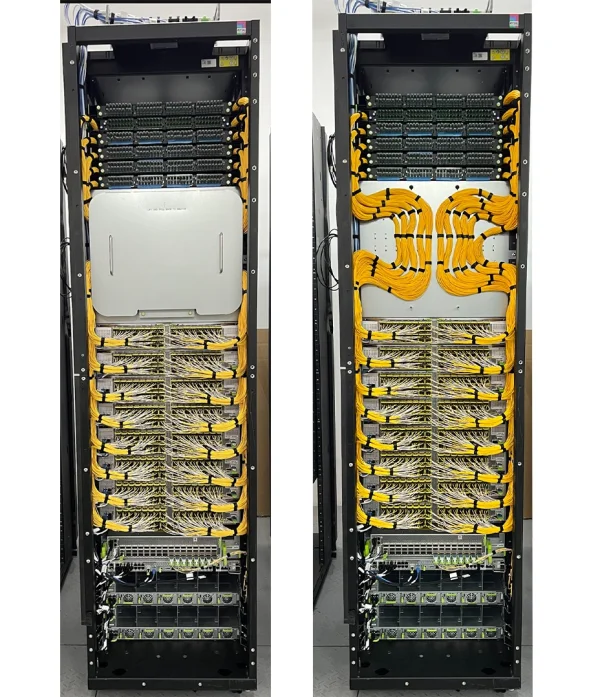
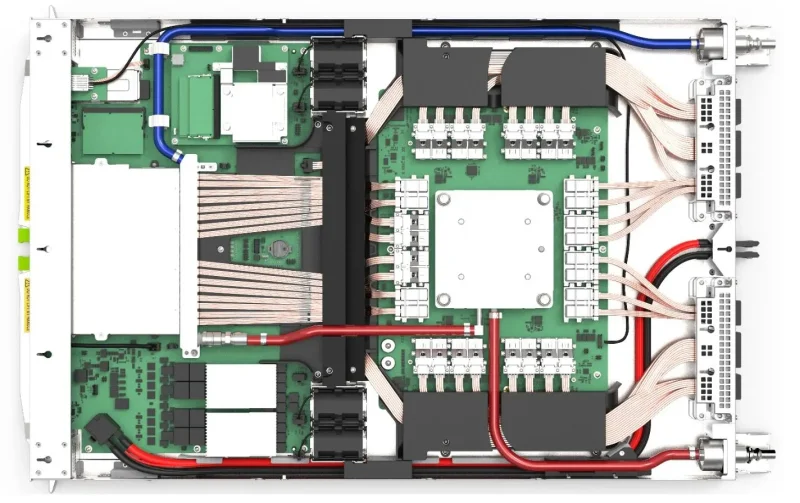
В состав оборудования входят коммутаторы IceCube с пропускной способностью 102,4 Тбит/с в стойке IcePack (ORv3-HPRv1) с жидкостным охлаждением. В каждой стойке размещаются коммутационные модули IceCube — устройства с пропускной способностью 102,4 Тбит/с, обеспечивающие неблокирующую коммутацию для 128 портов по 800 Гбит/с каждый. Модули IceCube выпускаются в двух исполнениях: на основе специализированных интегральных схем (ASIC) Broadcom Tomahawk6C или NVIDIA Spectrum-6.
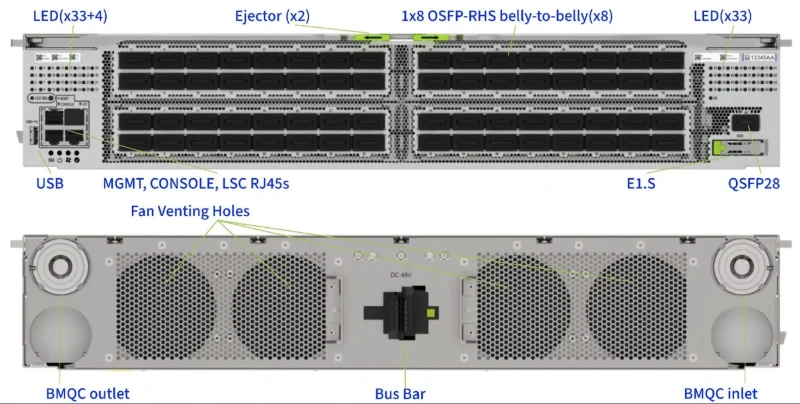
IceCube
Обе системы функционируют на базе открытой сетевой операционной системы FBOSS от Meta✴, опирающейся на интерфейс абстракции коммутаторов OCP SAI (Switch Abstraction Interface). В рамках архитектуры Open Switch Platform Architecture (OSPA) реализованы управляющие функции, в том числе порядок подачи питания, идентификация компонентов, контроль температурного режима, восстановление прошивки и диагностические процедуры.
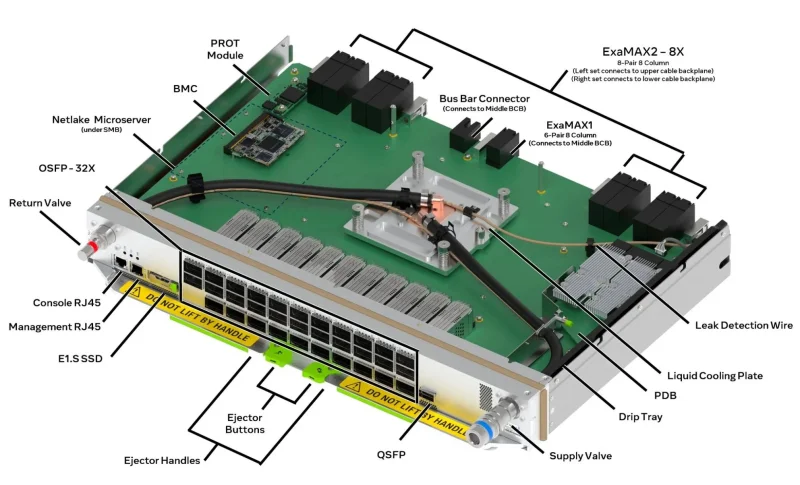
Tahan
Архитектура FPF смещает акцент управления платформой в сторону хоста, при этом классический BMC остаётся для задач мониторинга и восстановления. FPGA-мосты ввода-вывода, подсоединяемые по PCIe, агрегируют периферийные интерфейсы, а иерархическая модель инвентаризации оборудования даёт программному обеспечению унифицированный механизм перечисления компонентов. В предложении также предусмотрены автономное управление электропитанием, выявление протечек и резервные копии прошивки. Важно подчеркнуть: речь идёт о проектных требованиях на стадии обсуждения, а не о подтверждении совместимости всех решений от участвующих производителей.
ESUN для MTIA 300
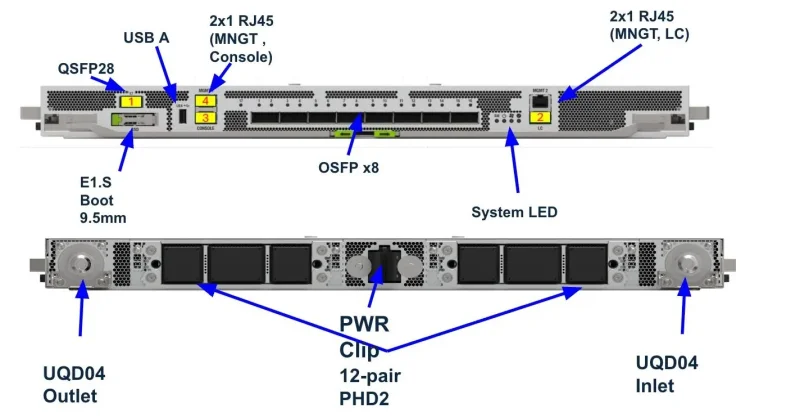
Кроме того, Meta✴ раскрыла детали о коммутаторе Tahan Ethernet Scale Up, предназначенном для MTIA 300, продемонстрировала прототип стойки, вмещающей 72 ускорителя, и объявила об открытой реализации MetaRoCE. Указанные компоненты находятся на разных этапах готовности: на данный момент Tahan работает в режиме lossless RoCE, тогда как в перспективных аппаратных решениях для вертикального масштабирования запланирован переход на ESUN, а версия OSPA 1.0.0 по-прежнему ожидает рассмотрения в OCP.
ESUN для MTIA 300
Tahan создан на основе ASIC Tomahawk 5 с пропускной способностью 51,2 Тбит/с (64 × 800G). Четыре коммутатора Tahan объединяют 16 ускорителей в неблокирующей топологии. Компания подчеркнула, что Tahan задействует тот же lossless RoCE (маршрутизируемый IPv6, PFC и QoS, оптимизированный для ИИ), сводя вместе scale-up и scale-out сети под управлением FBOSS. Одновременно компания разрабатывает CXL-фабрики масштаба всего ЦОД.
Материалы по теме:
- Upscale AI представил архитектуру Token Fabric для ИИ-фабрик
- Arista представила интерконнект Etherlink SU-144 для кластеров ИИ и НРС
- Huawei представила архитектуру UnifiedBus для повышения производительности ИИ-кластеров
- Вглубь и вширь: Cornelis анонсировала архитектуру Active Compute Fabric
- Sugon создала китайский аналог NVIDIA InfiniBand NDR — интерконнект ScaleFabric
Источник:
- ***